El pasado día 15 de octubre, Meta y Apple dieron a conocer una colaboración conjunta para facilitar la ejecución en local del modelo de lenguaje Muse Spark Open, cuya denominación “open” le viene de tener los pesos de entrenamiento abiertos. Dicho modelo está pensado para poder ejecutar en local en los equipos informáticos de la marca de la manzana mordida, con lo que ofrece a las organizaciones la privacidad de sus datos, que no se tienen que subir a servicios online.
Pero lo que seguramente ha sorprendido más de este modelo es la configuración hardware necesaria para que corra en un ordenador Apple: según el análisis que hace de ello la publicación estadounidense TechCrunch, el requisito para ejecutarlo con cierta soltura es el de disponer de 1 TB (un Terabyte) de memoria RAM.
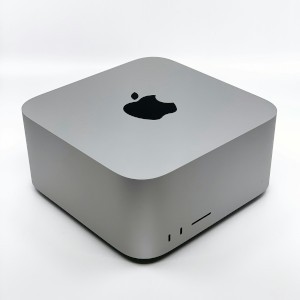
De hecho, al estar optimizado para su ejecución sobre el procesador M5 de Apple, exigió la conexión de dos Mac Studio con 512 GB de RAM cada uno de ellos.
Si el precio de 1 TB de memoria RAM viene a salir, dependiendo del tipo, la marca, y la cantidad de módulos, por entre 11.000 y 19.000 euros, el precio de un Mac Studio con 512 GB de RAM, suponiendo la configuración más potente a nivel de procesador sin pasar de 1 TB de almacenamiento en disco (algo que sería muy necesario en el caso que nos ocupa), supera los 25.000 euros. Y necesitamos dos, con lo que la ejecución de este modelo se nos lleva, sólo de entrada, más de 50.000 euros.
Según señalan desde TechCrunch, además de la elevada demanda de memoria, las estaciones de trabajo destinadas a ejecutar este software requieren de un suministro eléctrico y de un sistema de refrigeración a la altura.
La cifras de Muse Spark Open son reveladoras del porqué de estos requisitos tan extremos: su diseño se fundamenta en una estructura multimodal y de mezcla de expertos, un sistema que lo dota de capacidad para procesar distintos tipos de información simultáneamente, con 816.000 millones de parámetros y una ventana de contexto con soporte para un millón de tokens. Estas cifras facilitan el manejo de volúmenes de datos considerables en una sola operación, pero a base de devorar (más que consumir) recursos de hardware.
Su uso, pues, queda reservado a profesionales con un alto poder adquisitivo, y organizaciones que dispongan del presupuesto y las instalaciones para alojarlo y ejecutarlo.